0%

Bayesian Framework

Conditional=JointMarginal,p(x∣y)=p(x,y)p(y)\text{Conditional} = \frac{\text{Joint}}{\text{Marginal}},\quad p(x|y)=\frac{p(x,y)}{p(y)}

Product Rule

联合分布可以被表示为一维的条件分布的乘积

p(x,y,z)=p(x∣y,z)p(y∣z)p(z)p(x,y,z)=p(x|y,z)p(y|z)p(z)

Sum Rule

任何边缘分布可以利用联合分布通过积分得到

p(y)=∫p(x,y)dxp(y) = \int p(x,y)dx

Bayes理论

p(y∣x)=p(x,y)p(x)=p(x∣y)p(y)p(x)=p(x∣y)p(y)∫p(x∣y)p(y)dyp(y|x) = \frac{p(x,y)}{p(x)} = \frac{p(x|y)p(y)}{p(x)}=\frac{p(x|y)p(y)}{\int p(x|y)p(y)dy}

Bayes理论定义了当新的信息到来的时候,可能性的改变:

Posterior=Likelihood×PriorEvidence\text{Posterior} = \frac{\text{Likelihood} \times \text{Prior}}{\text{Evidence}}

统计推断(Statistical inference)

问题描述:

给定从分布p(x∣θ)p(x|\theta)中得到的独立同分布变量X=(x1,…,xn)X = (x_1,\ldots,x_n),来估计θ\theta

常规方法:

采用极大似然估计(maximum likelihood estimation)

θML=argmaxp(X∣θ)=argmax∏i=1np(xi∣θ)=argmax∑i=1n=logp(xi∣θ)\theta_{ML} = \arg \max p(X|\theta) = \arg \max \prod_{i=1}^{n}p(x_i|\theta) = \arg \max \sum_{i=1}^{n} = \log p(x_i|\theta)

贝叶斯方法:

用先验p(θ)p(\theta)来编码θ\theta的不确定性,然后采用贝叶斯推断

p(θ∣X)=∏i=1np(xi∣θ)p(θ)∫∏i=1np(xi∣θ)p(θ)dθp(\theta|X) = \frac{\prod_{i=1}^{n}p(x_i|\theta)p(\theta)} {\int \prod_{i=1}^{n}p(x_i|\theta)p(\theta)d\theta}

频率学派vs. 贝叶斯学派

频率学派 贝叶斯学派
变量 有随机变量也有确定的 全都是随机变量
适用范围 n>>dn>>d ∀n\forall n
  • 现代机器学习模型中可训练的参数数量已经接近训练数据的大小了

  • 频率学派得到的结果实际上是一种受限制的Bayesian方法:

    limn/d→∞p(θ∣x1,…,xn)=δ(θ−θML)\lim_{n/d \rightarrow \infty}p(\theta|x_1,\ldots,x_n)=\delta(\theta-\theta_{ML})

    注:此处的δ\delta函数指的是狄拉克函数

贝叶斯方法的优点

  • 可以用先验分布来编码我们的先验知识或者是希望的做种结果
  • 先验是一种正则化的方式
  • 相对于θ\theta的点估计方法,后验还包含有关于估计的不确定性关系的信息

概率机器学习模型

数据:

  • xx – 观察到变量的集合(features)
  • yy – 隐变量的集合(class label / hidden representation, etc.)

模型:

  • θ\theta – 模型的参数(weights)

Discriminative probabilistic ML model
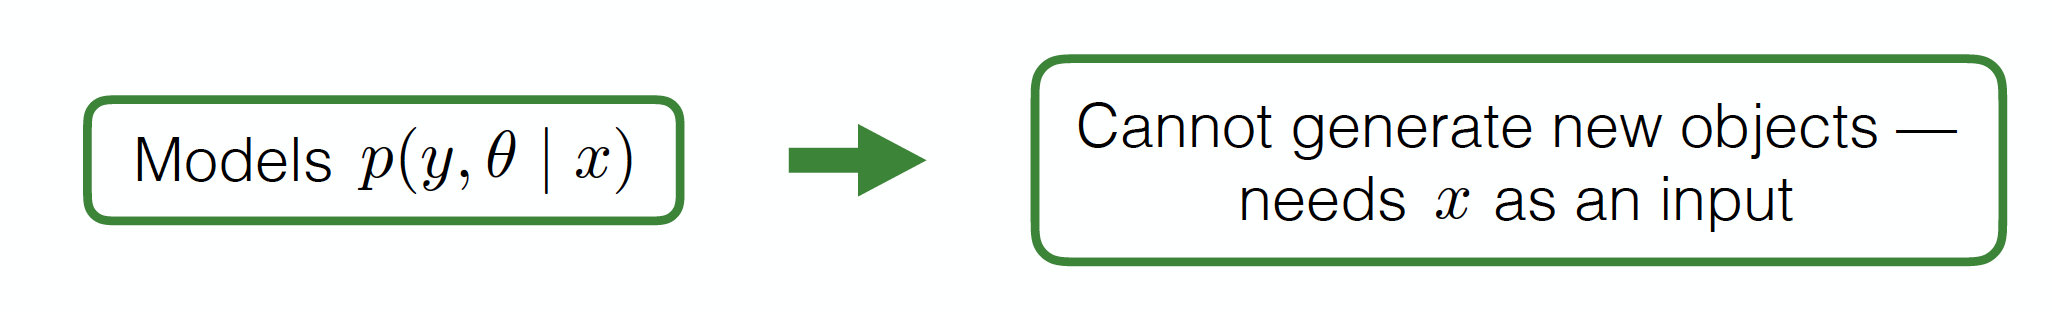
通常假设θ\theta的先验与xx没有关系

p(y,θ∣x)=p(y∣x,θ)p(θ)p(y,\theta|x) = p(y|x,\theta)p(\theta)

Examples:

  • 分类或者回归任务(隐层表示比观测空间简单得多)
  • 机器翻译(隐层表示和观测的空间有着相同的复杂度)

Generative probabilistic ML model
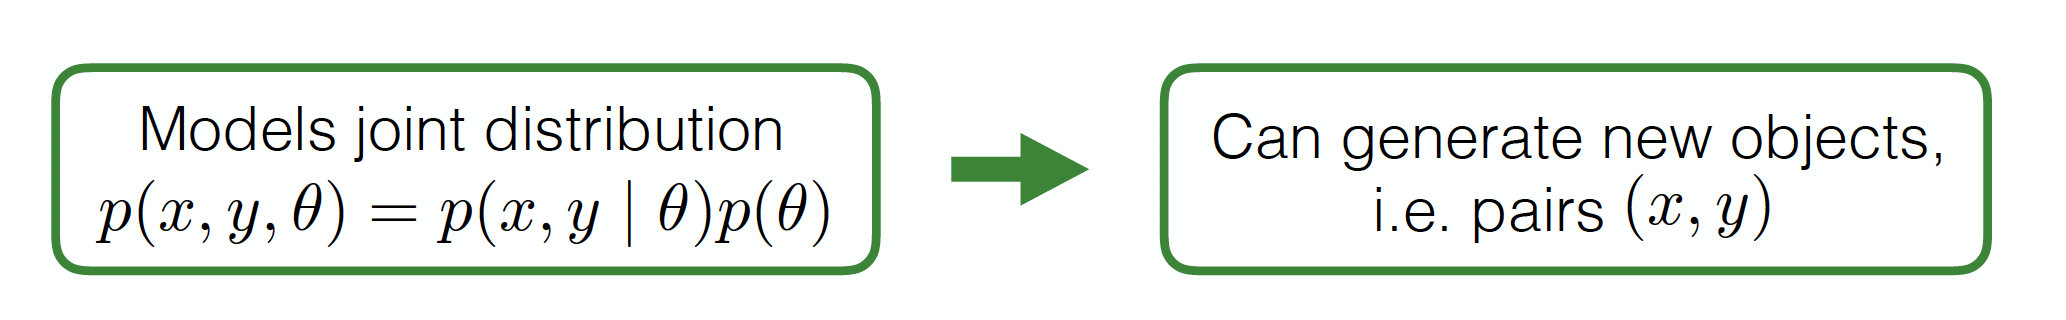
可能会很难训练,因为通常而言观测到的xx会比隐层复杂很多。

Examples:

  • 文本,图片的生成

贝叶斯机器学习模型的训练与预测

Training阶段:θ\theta上的贝叶斯推断

p(θ∣Xtr,Ytr)=p(Ytr∣Xtr,θ)p(θ)∫p(Ytr∣Xtr,θ)p(θ)dθp(\theta|X_{tr},Y_{tr}) = \frac{p(Y_{tr}|X_{tr},\theta)p(\theta)} {\int p(Y_{tr}|X_{tr},\theta)p(\theta) d\theta}

结果:采用p(θ)p(\theta)分布比仅仅采用一个θML\theta_{ML}有着更好地效果

  • 模型融合总是比一个最优模型的效果更好
  • 后验分布里面含有所有从训练数据中学到的相关内容,并且可以模型提取用于计算新的后验分布

Testing阶段:

  • 从training中我们得到了后验分布p(θ∣Xtr,Ytr)p(\theta|X_{tr},Y_{tr})
  • 获得了新的的数据点xx
  • 需要计算对于yy的预测

p(y∣x,Xtr,Ytr)=∫p(y∣x,θ)p(θ∣Xtr,Ytr)dθp(y|x,X_{tr},Y_{tr}) = \int p(y|x,\theta) p(\theta|X_{tr},Y_{tr})d\theta

重新看一遍

训练阶段:

p(θ∣Xtr,Ytr)=p(Ytr∣Xtr,θ)p(θ)∫p(Ytr∣Xtr,θ)p(θ)dθp(\theta|X_{tr},Y_{tr}) =\frac{p(Y_{tr}|X_{tr},\theta)p(\theta)}{\color{red}{\int p(Y_{tr}|X_{tr},\theta)p(\theta) d\theta}}

测试阶段:

p(y∣x,Xtr,Ytr)=∫p(y∣x,θ)p(θ∣Xtr,Ytr)dθp(y|x,X_{tr},Y_{tr}) =\color{red}{\int p(y|x,\theta) p(\theta|X_{tr},Y_{tr})d\theta }

红色部分的内容通常是难以计算的!

共轭分布

我们说分布p(y)p(y)和p(x∣y)p(x|y)是共轭的当且仅当p(y∣x)p(y|x)和p(y)p(y)是同类的,即后验分布和先验分布同类。

p(y)∈A(α),p(x∣y)∈B(β)⇒p(y∣x)∈A(α′)p(y)\in \mathcal A(\alpha),\quad p(x|y)\in \mathcal B(\beta)\quad \Rightarrow \quad p(y|x)\in \mathcal A(\alpha^{\prime})

Intuition:

p(y∣x)=p(x∣y)p(y)∫p(x∣y)p(y)dy∝p(x∣y)p(y)p(y|x) = \frac{p(x|y)p(y)}{\int p(x|y)p(y)dy}\propto p(x|y)p(y)

  • 由于任何A\mathcal A中的分布是归一化的,分母是可计算的
  • 我们需要做的就是计算α′\alpha^{\prime}

这种情况下贝叶斯推断可以得到闭式解!

常见的共轭分布如下表:

Likelihood p(x∣y)p(x\mid y) yy Conjugate prior p(y)p(y)
Gaussian μ\mu Gaussian
Gaussian σ−2\sigma^{-2} Gamma
Gaussian (μ,σ−2)(\mu,\sigma^{-2}) Gaussian-Gamma
Multivariate Gaussian Σ−1\Sigma^{-1} Wishart
Bernoulli pp Beta
Multinomial (p1,…,pm)(p_1,\ldots,p_m) Dirichlet
Poisson λ\lambda Gamma
Uniform θ\theta Pareto

举个例子:丢硬币

  • 我们有一枚可能是不知道是否均匀的硬币
  • 任务是预测正面朝上的概率θ\theta
  • 数据:X=(x1,…,xn)X=(x_1,\ldots,x_n),x∈{0,1}x\in\{0,1\}

概率模型如下:

p(x,θ)=p(x∣θ)p(θ)p(x,\theta) = p(x|\theta)p(\theta)

其中对于p(x∣θ)p(x|\theta)的似然为:

Bern(x∣θ)=θx(1−θ)1−xBern(x|\theta) = \theta^x(1-\theta)^{1-x}

但是不知道p(θ)p(\theta)的先验是多少

怎样选择先验概率分布?

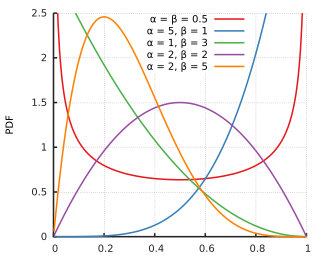
  • 正确的定义域:θ∈[0,1]\theta \in [0,1]
  • 包含先验知识:一枚硬币是均匀的可能性非常大
  • 推断复杂度的考虑:使用共轭先验

Beta分布是满足所有条件的!

Beta(θ∣a,b)=1B(a,b)θa−1(1−θ)b−1Beta(\theta|a,b) = \frac{1}{\mathrm{B}(a,b)}\theta^{a-1}(1-\theta)^{b-1}

同样也适用于大部分不均匀硬币的情况

让我们来检验似然和先验是不是共轭分布:

p(x∣θ)=θx(1−θ)1−xp(θ)=1B(a,b)θa−1(1−θ)b−1p(x|\theta)=\theta^x(1-\theta)^{1-x}\qquad p(\theta) = \frac{1}{\mathrm{B}(a,b)}\theta^{a-1}(1-\theta)^{b-1}

方法——检验先验和后验是不是在同样的参数族里面

p(θ)=Cθα(1−θ)βp(θ∣x)=C′p(x∣θ)p(θ)=C′θx(1−θ)1−x1B(a,b)θa−1(1−θ)b−1=C′B(a,b)θx+a−1(1−θ)b−x=C′′θα′(1−θ)β′\begin{aligned} p(\theta)&=C\theta^{\alpha}(1-\theta)^{\beta}\\ p(\theta|x)&=C^{\prime}p(x|\theta)p(\theta)\\ &=C^{\prime}\theta^x(1-\theta)^{1-x}\frac{1}{\mathrm{B}(a,b)}\theta^{a-1}(1-\theta)^{b-1}\\ &=\frac{C^{\prime}}{\mathrm{B}(a,b)}\theta^{x+a-1}(1-\theta)^{b-x}\\ &=C^{\prime\prime}\theta^{\alpha^{\prime}}(1-\theta)^{\beta^{\prime}} \end{aligned}

由于先验和后验形式相同,所以确实是共轭的!

现在考虑接收到数据之后的贝叶斯推断:

p(θ∣X)=1Zp(X∣θ)p(θ)=1Zp(θ)∏i=1np(xi∣θ)=1Z1B(a,b)θa−1(1−θ)b−1∏i=1nθxi(1−θ)1−xi=1Z′θa+∑i=1nxi−1(1−θ)b+n−∑i=1n−1=1Z′θa′−1(1−θ)b′−1\begin{aligned} p(\theta|X) &= \frac{1}{Z}p(X|\theta)p(\theta)\\ &= \frac{1}{Z}p(\theta)\prod_{i=1}^{n} p(x_i|\theta) \\ &=\frac{1}{Z} \frac{1}{\mathrm{B}(a,b)}\theta^{a-1}(1-\theta)^{b-1} \prod_{i=1}^{n} \theta^{x_i}(1-\theta)^{1-x_i}\\ &=\frac{1}{Z^{\prime}}\theta^{a+\sum_{i=1}^n x_i -1}(1-\theta)^{b+n-\sum_{i=1}^n-1}\\ &=\frac{1}{Z^{\prime}}\theta^{a^\prime -1}(1-\theta)^{b^\prime -1} \end{aligned}

新的参数为:

a′=a+∑i=1nxib′=b+n−∑i=1nxia^\prime = a+\sum_{i=1}^nx_i \qquad b^{\prime}=b+n-\sum_{i=1}^nx_i

那么问题来了,当没有共轭分布的时候我们应该怎么做?

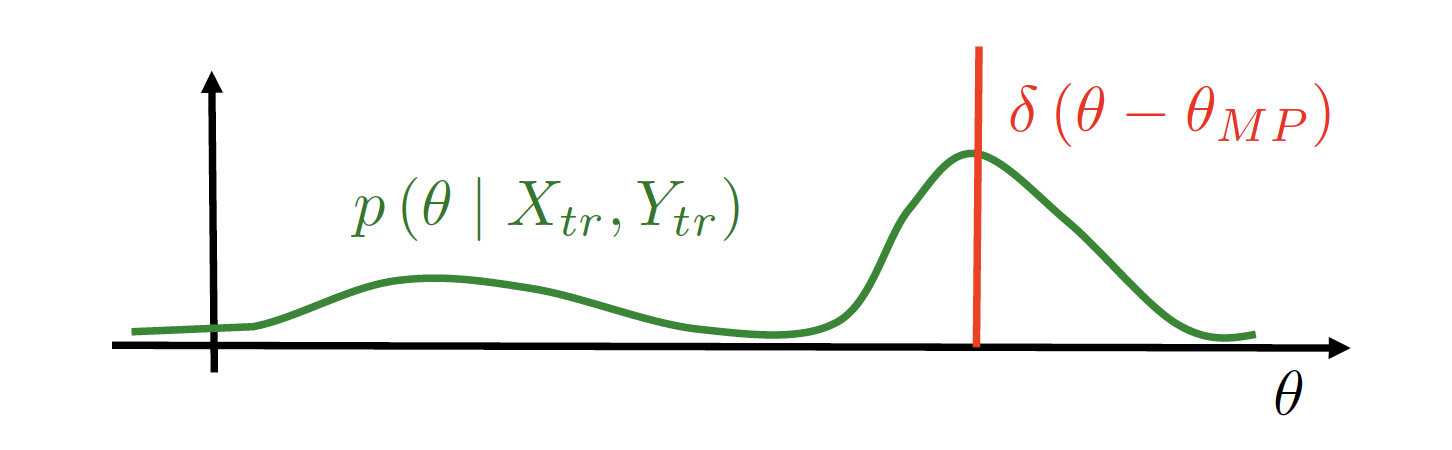
最简单的方法:选择可能性最高的参数

训练阶段:

θMP=argmaxp(θ∣Xtr,Ytr)=argmaxp(Ytr∣Xtr,θ)p(θ)\theta_{MP}=\arg \max p(\theta|X_{tr},Y_{tr}) = \arg \max p(Y_{tr}|X_{tr},\theta)p(\theta)

测试阶段:

p(y∣x,Xtr,Ytr)=∫p(y∣x,θ)p(θ,Xtr,Ytr)dθ≈p(y∣x,θMP)p(y|x,X_{tr},Y_{tr}) = \int p(y|x,\theta)p(\theta,X_{tr},Y_{tr})d\theta \approx p(y|x,\theta_{MP})

这种情况下我们并不能计算出正确的后验。